Llama.cpp, Ollama e vLLM: API comuni, vincoli diversi
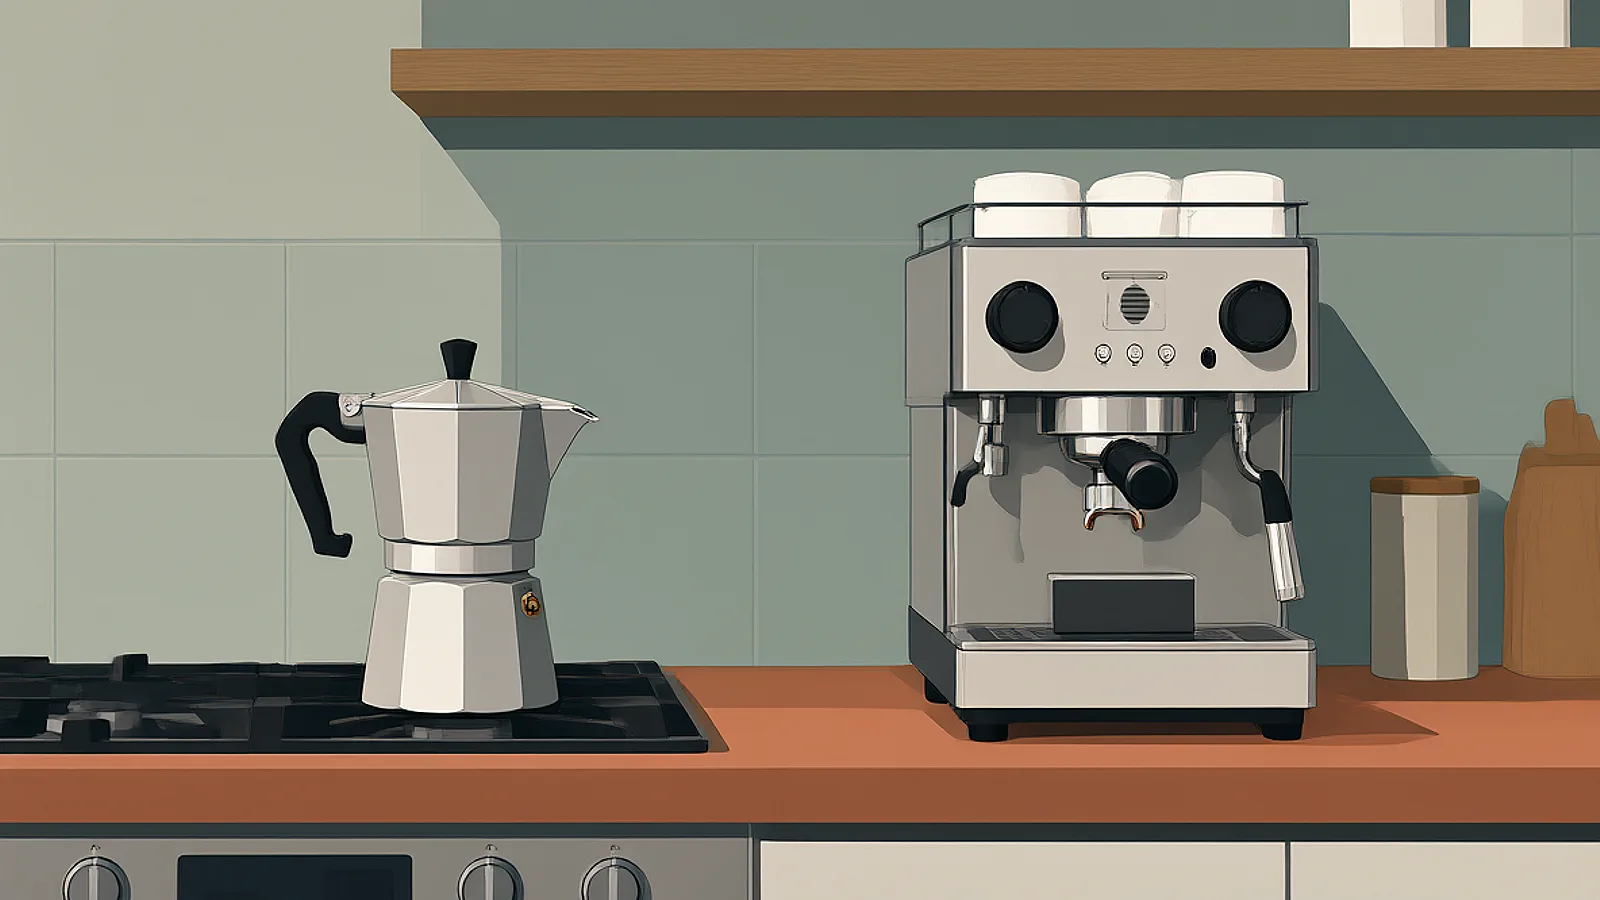
llama.cpp, Ollama e vLLM permettono di eseguire modelli linguistici, ma non risolvono lo stesso problema allo stesso livello. Nel passaggio del mio talk «Dal modello a WordPress: MLOps con AI locale», al WordCamp Pisa 2026, uso l’immagine della moka e della macchina da bar: entrambe fanno il caffè, ma servono esigenze diverse. La distinzione aiuta a orientarsi. Per scegliere un motore di inferenza o dimensionare un servizio, approfondisco come ciascuno gestisce il lavoro e le risorse.
Il punto è separare tre decisioni: quale modello usare, come eseguirlo e attraverso quale interfaccia chiamarlo. Un’API compatibile con OpenAI può rendere più semplice cambiare il servizio dietro un’integrazione. Memoria disponibile, richieste parallele, funzionalità e qualità delle risposte restano aspetti da valutare separatamente. Nella mia guida uso Ollama per la demo; questo non costituisce un confronto prestazionale con gli altri strumenti, né documenta una migrazione di produzione.
llama.cpp, Ollama e vLLM: tre ruoli da distinguere
Il modello contiene i pesi necessari al calcolo. Il motore di inferenza li carica ed esegue le operazioni che producono la risposta. Il server espone queste capacità a un’applicazione attraverso un’API. Sono livelli distinti, anche quando un singolo strumento ne gestisce più di uno.
llama.cpp è un progetto di inferenza in C/C++, basato sulla libreria ggml, orientato all’esecuzione su hardware eterogeneo. Include anche un server con API compatibile OpenAI. Non è quindi confinato all’uso da terminale o a una sola richiesta per volta.
Ollama semplifica la gestione e l’avvio dei modelli. Nella demo lo scelgo come punto di ingresso: riduce i passaggi necessari per arrivare a un modello utilizzabile da un’applicazione. Per l’integrazione conta soprattutto il servizio che espone e il modo in cui il client lo raggiunge, oltre all’interfaccia grafica.
vLLM è una libreria per inferenza e serving, con ottimizzazioni dedicate alla gestione delle richieste e della memoria. Oltre alle API, presenti anche negli altri strumenti, conta l’insieme di scheduling, batching e possibilità di esecuzione distribuita. La metafora della macchina da bar riguarda soprattutto questa organizzazione del lavoro.
llama.cpp: la flessibilità hardware non elimina il vincolo di memoria
Il supporto hardware di llama.cpp comprende Apple Silicon, CPU x86 e RISC-V, GPU NVIDIA e AMD, oltre a backend come Vulkan e SYCL. La possibilità di distribuire l’inferenza fra CPU e GPU permette anche di eseguire parzialmente sulla GPU modelli che non entrano interamente nella sua memoria dedicata.
Questo è il significato operativo dell’offload: una parte del lavoro viene assegnata alla GPU, mentre un’altra resta sul lato CPU. Il modello non diventa più piccolo perché cambia la distribuzione del calcolo. Cambiano le risorse coinvolte e i possibili colli di bottiglia, compresi memoria di sistema e trasferimenti fra componenti.
Nel talk invito a sperimentare con una GPU da gaming o con un Mac dotato di memoria sufficiente. Per dimensionare queste configurazioni servono modello, quantizzazione e contesto: sono questi elementi a determinare quale quantità di RAM permetta un’esecuzione con una latenza accettabile. Il dimensionamento richiede di distinguere VRAM, memoria unificata e offload, non soltanto di sommare i gigabyte disponibili.
llama.cpp prevede quantizzazioni intere da 1,5 a 8 bit. Usare meno bit per rappresentare i pesi riduce il loro ingombro e può favorire l’esecuzione su risorse limitate. Nel conto della memoria del processo restano anche le strutture di lavoro e la memoria necessaria a elaborare il contesto.
Va distinta anche la quantizzazione dal formato del file. GGUF è utilizzato nell’ecosistema di llama.cpp e documentato anche fra i formati supportati da vLLM. Il supporto a un formato non garantisce, da solo, che ogni modello e ogni sua funzione siano utilizzabili su qualsiasi backend. Per una scelta concreta verifico la combinazione completa, non soltanto l’estensione del file.
Ollama: partire in locale e sapere dove passa la richiesta
Il vantaggio di Ollama, nella demo, è ridurre l’attrito iniziale. L’obiettivo è arrivare al collegamento fra modello e applicazione senza trasformare la preparazione dell’ambiente nel tema principale. È una scelta di percorso; la velocità del servizio va valutata sul carico previsto.
La documentazione mostra come usare un client OpenAI verso l’indirizzo http://localhost:11434/v1/. Il client richiede un valore per la chiave API, ma il server Ollama locale lo ignora. Questa distinzione è importante: un campo obbligatorio nel client non dimostra che il servizio stia autenticando le richieste.
Ollama documenta anche l’accesso diretto al cloud, con chiave API, senza richiedere un’installazione locale. Per usare modelli cloud attraverso il server locale è invece necessario accedere a Ollama. Per sapere se l’elaborazione resta sul mio computer, controllo quale modello viene invocato e quale percorso segue la richiesta.
La compatibilità OpenAI documentata da Ollama comprende esempi con chat completions, anche con immagini, e Responses. La stessa documentazione delimita alcune funzioni cloud: non sono supportati Responses con stato, ricerca web integrata tramite quel percorso o replay di chiamate a tool personalizzate o a formato libero. La compatibilità va quindi verificata per le operazioni effettivamente usate dall’applicazione.
vLLM: il throughput dipende da come si organizza il lavoro
Quando arrivano richieste contemporanee, il problema cambia. Non basta che il modello entri in memoria: occorre assegnare lavoro all’hardware senza lasciare risorse inutilizzate e senza far crescere troppo l’attesa. Qui diventano rilevanti le ottimizzazioni che vLLM documenta, fra cui continuous batching, PagedAttention, chunked prefill e prefix caching.
Il continuous batching permette di aggiornare il gruppo di richieste in esecuzione mentre il servizio lavora. Le richieste non hanno tutte la stessa durata: alcune terminano prima, altre continuano a generare. Inserire nuovo lavoro quando si libera capacità può sfruttare meglio l’hardware rispetto a gruppi che devono avanzare e concludersi rigidamente insieme.
PagedAttention riguarda invece la gestione della cache di chiavi e valori dell’attenzione, la KV cache. Durante la generazione il modello conserva informazioni sui token già elaborati per riutilizzarle nei passaggi successivi. Con più richieste e contesti più lunghi, questa memoria diventa un vincolo distinto dai pesi del modello.
La gestione per blocchi della KV cache mira a rendere più efficiente l’allocazione della memoria. Il beneficio cercato riguarda il lavoro concorrente, mentre il costo di ogni operazione resta un aspetto distinto. Un miglior uso della memoria può consentire più richieste attive; il risultato sulla latenza resta da misurare sul carico reale.
La documentazione di vLLM comprende anche inferenza distribuita, con diverse forme di parallelismo, streaming, output strutturati e tool calling. Il supporto hardware non si limita alle GPU NVIDIA: sono indicati anche GPU AMD, varie architetture CPU e dispositivi tramite plugin. Questo amplia le possibilità di configurazione del servizio. Serve verificare il percorso supportato per modello, hardware e funzionalità richieste.
API compatibile OpenAI: cambiare indirizzo è solo il primo passo
Nel talk dico che, cambiando il motore sottostante, possiamo mantenere l’integrazione e modificare il baseUrl. Questo percorso funziona quando il client usa operazioni comuni supportate da entrambi i servizi. Per valutare la sostituzione completa, distinguo collegamento, contratto API e comportamento del modello.
Conviene distinguere tre livelli. Il primo è il collegamento: il client riesce a raggiungere il server. Il secondo è il contratto API: endpoint, parametri e risposte sono quelli attesi. Il terzo è il comportamento del modello: istruzioni, qualità, uso degli strumenti e rispetto dei formati richiesti. Ciascun livello richiede una verifica distinta.
Un’integrazione che invia testo e riceve testo ha un perimetro diverso da un agente che usa immagini, streaming, output strutturati e tool. In quest’ultimo caso, la migrazione deve verificare ciascuna capacità. Anche quando la struttura della chiamata resta uguale, un modello diverso può produrre risposte diverse e richiedere nuove valutazioni.
Questa interfaccia comune rende comunque interessante un’architettura ibrida. In uno scenario ipotetico, un’applicazione potrebbe inviare alcune richieste a un modello locale e altre a un servizio remoto con un modello di frontiera. La scelta può dipendere dalla complessità del compito o dal perimetro dei dati, senza duplicare necessariamente tutta l’integrazione.
Il routing, però, diventa una decisione di governance. Bisogna stabilire quali contenuti possano uscire dall’ambiente locale e se un fallback remoto sia consentito. Un errore del servizio locale non dovrebbe trasformarsi automaticamente in un’autorizzazione a trasferire dati altrove. L’API comune semplifica il collegamento; non decide la politica di trattamento dei dati.
Benchmark: manca un confronto diretto fra questi tre strumenti
Il benchmark confronta vLLM, LMDeploy e SGLang, senza includere llama.cpp e Ollama. Il test usa Llama 3.1 8B-Instruct in bfloat16, una NVIDIA H100 da 80 GB e prompt ShareGPT, con un carico batch offline. Non offre quindi una classifica utilizzabile per scegliere fra i tre strumenti discussi qui.
Oltre ai concorrenti inclusi, conta il tipo di carico. Il throughput offline misura quanto lavoro viene completato nelle condizioni del test. Un’applicazione interattiva deve considerare anche quanto tempo passa prima del primo token, quanto dura la risposta e come cambiano i tempi quando aumentano le richieste contemporanee.
Per un confronto utile manterrei dichiarati modello, quantizzazione, hardware, lunghezza dei prompt e delle risposte, numero di richieste concorrenti e funzionalità abilitate. Misurerei poi separatamente velocità, latenza, memoria ed errori. Per attribuire un miglioramento al solo motore, manterrei invariato il modello.
La scelta parte dal carico, non dalla promessa di compatibilità
Per riprodurre il percorso della demo, Ollama resta il punto di partenza della mia guida pratica. Quando serve controllare più direttamente backend, quantizzazione e distribuzione del lavoro fra CPU e GPU, llama.cpp offre un perimetro da valutare. Quando il problema principale diventa servire richieste concorrenti, vLLM mette a disposizione meccanismi pensati per organizzare quel carico.
Non sono confini assoluti. La scelta va validata con il modello previsto, sull’hardware disponibile e con richieste rappresentative. La semplicità iniziale può ridurre il lavoro di configurazione; un serving più articolato può migliorare l’impiego delle risorse, ma richiede verifiche e gestione. Il costo non scompare: cambia posizione.
Il criterio che userei è questo: prima stabilire dove possono passare i dati e quale risposta è accettabile, poi misurare se memoria e capacità di servizio bastano. Il collo di bottiglia può essere il modello troppo grande, la coda delle richieste oppure una funzione API mancante. Per riprendere il percorso dal modello all’integrazione con WordPress, il riferimento è il talk completo. La continuità dell’interfaccia aiuta a cambiare motore; la continuità del servizio va dimostrata.